
vLLM Kullanırken KV Cache ‘in Önemi
vLLM, büyük dil modellerinin (LLM) çıkarım (inference) sürecini, özellikle Attention (Dikkat) mekanizmasının maliyetli hesaplamalarını optimize ederek hızlandırmak için tasarlanmış, yüksek performanslı bir araçtır. KV Cache (Key-Value Cache), bu optimizasyonun merkezinde yer alır.
1. KV Cache Nedir?
Transformer tabanlı bir LLM’de, her bir dikkat (Attention) bloğu, gelen girdiyi (token’ları) üç farklı vektör setine dönüştürür: Query ($\mathbf{Q}$), Key ($\mathbf{K}$) ve Value ($\mathbf{V}$).
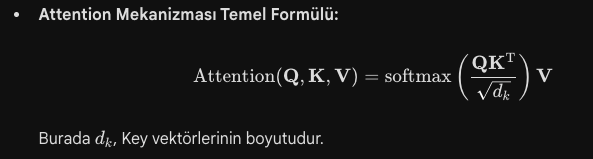
- Oluşturma (Generation) Aşamasında: Model, bir sonraki token’ı üretmek için her adımda mevcut token’ı (Query) daha önce üretilen tüm token’larla (Key’ler ve Value’lar) ilişkilendirerek (Attention) bağlamı hesaplar.
- KV Cache’in Rolü: KV Cache, daha önce hesaplanmış olan tüm Key (K) ve Value (V) çiftlerini bellek (genellikle GPU belleği) üzerinde saklar. Bu sayede, yeni bir token üretilirken, önceden hesaplanan bu ${K}$ ve ${V}$ vektörlerinin yeniden hesaplanmasına gerek kalmaz.
2. Neden Önemli ve Ne İşe Yarar? (Performans Katkıları)
KV Cache, LLM çıkarımında iki kritik sorunu çözer: çıkarım hızını (latency) artırır ve verimi (throughput) yükseltir.
a. Hız (Latency) ve Tekrarlayan Hesaplamaların Önlenmesi
KV Cache olmadan, her yeni token üretim adımında, dikkat mekanizmasının tüm giriş dizisi üzerinden (prompt + şimdiye kadar üretilen token’lar) tekrar tekrar hesaplanması gerekir. Dizi uzadıkça bu hesaplama maliyeti kuadratik olarak artar.
- Dizi uzunluğu $L$ ise, hesaplama karmaşıklığı $O(L^2)$’dir.
- KV Cache kullanıldığında, her adımda sadece yeni token’ın ${Q}$ vektörü, önbellekteki ${K}$ ve ${V}$ çiftleriyle birleştirilir. Bu, hesaplama maliyetini her adımda neredeyse $O(1)$ veya $O(L)$ (dizi uzunluğuna bağlı olarak) seviyesinde tutar.
- Sonuç: Özellikle uzun cevaplar üretilirken çıkarım süresini (TTFT – Time To First Token ve TBT – Time Between Tokens) dramatik şekilde kısaltır.
b. Verim (Throughput) ve GPU Belleği Kullanımı (vLLM’e Özel)
KV Cache’in kendisi büyük miktarda GPU belleği tüketir. Bu, birden fazla isteği (request) aynı anda işleyen bir sunucu ortamında (paralel çalıştırma/batching) darboğaz yaratabilir.
vLLM, bu bellek sorununu PagedAttention adlı yenilikçi bir mekanizma ile çözer.
- PagedAttention:
- Geleneksel LLM sunucuları, her isteğe (request) sabit ve tahmini bir maksimum uzunluğa yetecek kadar bellek ayırır (statik tahsis). Bu durum, çoğunlukla kullanılmayan bellek parçalarının boşa gitmesine (bellek parçalanması/fragmentation) neden olur.
- PagedAttention ise KV Cache’i, işletim sistemlerindeki sanal bellek (virtual memory) ve sayfalama (paging) mekanizmasına benzer şekilde, küçük, sabit boyutlu bloklara ayırır.
- Bu bloklar, sadece gerektiğinde tahsis edilir (dinamik tahsis) ve farklı isteklere ait KV Cache verileri, GPU belleği üzerinde dağınık bir şekilde bulunabilir ancak mantıksal olarak birbirine bağlı kalır.
- Sonuç: PagedAttention, KV Cache belleğinin çok daha verimli kullanılmasını sağlar, bellek israfını azaltır ve GPU’nun aynı anda daha fazla isteği işlemesine (yani daha yüksek verime) olanak tanır.
Özetlersek
| Kavram | Açıklama | Sonuç |
| KV Cache | Daha önce hesaplanmış Key ve Value vektörlerinin saklanması. | Her adımda tekrarlayan Attention hesaplamalarını önler. |
| Önemi (Hız) | Kuadratik $O(L^2)$ hesaplama maliyetini, lineer $O(L)$ veya sabit $O(1)$’e yakın bir seviyeye düşürür. | Çıkarım süresini (latency) azaltır, modelin daha hızlı yanıt vermesini sağlar. |
| Önemi (Verim/vLLM) | vLLM’in PagedAttention mimarisi ile birleşerek, KV Cache için GPU belleğini parçalı bloklar halinde dinamik yönetir. | Bellek kullanım verimliliğini maksimize eder, aynı donanımda daha fazla eşzamanlı istek (throughput) işlenmesine olanak tanır. |
KV Cache, vLLM ve benzeri yüksek performanslı çıkarım motorları için, LLM’lerin canlı sunucu ortamlarında düşük gecikme ve yüksek verimle çalışabilmesi için vazgeçilmez bir optimizasyon aracıdır.