AI 2040: Süper Zekâya Giden Yolda “Plan A” Yarışı Durdurup Zaman Kazanmak Mümkün mü?
Yapay zeka alanında çalışan herkesin zihninde aynı soru dönüp duruyor: İnsan üstü yeteneklere sahip modeller geldiğinde, bu gücü kim kontrol edecek? AI Futures Project’in (aynı zamanda 2027 tahminleriyle gündeme gelen ekibin) yayınladığı “AI 2040: Plan A” çalışması, bu soruya somut ve tartışmaya açık bir cevap arıyor. Bir güvenlik araştırmacısı olarak bu raporu detaylı şekilde inceledim; hem senaryonun kurgusunu hem de altındaki teknik güvenlik önerilerini bu yazıda özetliyorum.
Önemli bir not baştan: Bu rapor bir kehanet değil, bir politika önerisi. Yazarlar, önerdikleri senaryonun gerçekleşmesini beklemiyorlar; amaçları, önerilerini somut bir gelecek kurgusu üzerinden test etmek ve tartışmaya açmak.
🔗 Kaynak: ai-2040.com | PDF: AI-2040.pdf
Plan A’nın Temel Fikri
Ekip, bir önceki çalışmaları olan AI 2027’de, kontrolsüz bir yarışın iki uçtan birine — insanlığın yok oluşuna ya da gücün geri döndürülemez biçimde tekelleşmesine — götürebileceğini savunmuştu. Plan A, buna karşı önerilen “iyimser ama gerçekçi” alternatif.
Senaryonun özü şu üç unsura dayanıyor:
- Uluslararası şeffaflık: AI Ar-Ge süreçlerinin büyük ölçüde kamuya ve karşı tarafa (ABD-Çin ekseninde) açık hale getirilmesi, böylece kimsenin gizlice ilerleme kaydedemeyeceği bir ortam kurulması.
- Kontrollü ve doğrulanabilir yavaşlama: Süper zekâya geçişin aniden değil, insan uzman seviyesinde bir “duraklama” evresinden geçerek 2040 yılına kadar kademeli şekilde ertelenmesi.
- Güç dağılımı: Sadece iki-üç şirketin değil, dünya genelinde onlarca kuruluşun frontier (sınır) seviyesine yetişebildiği, rekabetin gizlilik yerine denetlenebilirlik üzerinden yürüdüğü bir ekosistem.
Yazarlar bunu “karşılıklı garantili işlem gücü imhası” (mutually assured compute destruction) rejimine benzer bir denge olarak tanımlıyor — Soğuk Savaş döneminin nükleer caydırıcılık mantığının hesaplama gücüne uyarlanmış hali.
Senaryonun Zaman Çizelgesi
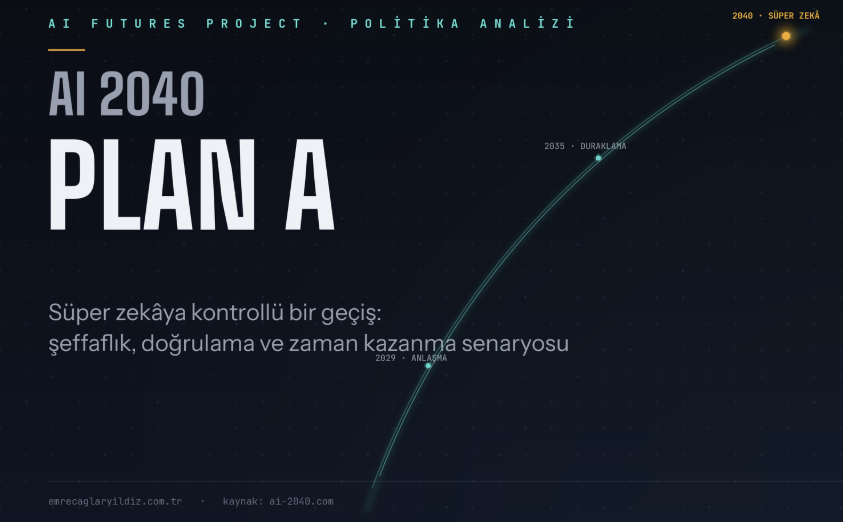
Raporun kurgusal anlatımı, gerçek olaylarla karışmaması için ayrı ele alınmalı; bu bir tahmin değil, “eğer doğru adımlar atılırsa ne olabilir” sorusuna verilen kurgusal bir yanıt. Buna göre önerilen takvim şöyle:
- 2029: ABD ve Çin, kontrolsüz bir süper zekâ yarışından kaçınmak için anlaşmaya varıyor.
- 2030: Anlaşma olmasaydı, bu yılın sonunda yapay zeka Ar-Ge’sinin tamamen otomatikleşmesiyle süper zekâya ulaşılmış olacaktı — anlaşma sayesinde bu senaryodan kaçınılıyor.
- 2030-2035: Modeller, insan uzmanlarla kıyaslanabilir seviyeye kadar kontrollü şekilde ölçekleniyor.
- 2035: İnsan kontrolünü korumak amacıyla bu seviyede bilinçli bir duraklama yapılıyor.
- 2040: Duraklama kaldırılıyor ve süper zekâya geçiliyor — raporun adının kaynağı da bu.
Yazarlar, bu tarihi seçerken kendi ekip içi tahmin belirsizliklerini de yansıtmak istediklerini belirtiyor; bir önceki çalışmalarında 2027 varsayılmışken, bu kez farklı ekip üyelerinin öngörüleri 2030’lara işaret ediyor.
Alternatif Senaryolar: Plan A Neden “En İyi Kötü Seçenek” Değil, Gerçekten İyi Seçenek?
Raporun en çarpıcı yanlarından biri, Plan A’yı diğer olası politika yönelimleriyle (Plan B, C, D, S) karşılaştırdığı analiz bölümü. Kabaca:
| Plan | Yaklaşım | Beklenen “iyi gelecek” olasılığı* |
|---|---|---|
| A | Doğrulanabilir yavaşlama + tam araştırma şeffaflığı | ~42% |
| B | Rakibi sabote ederek zaman kazanma (siber/kinetik) | ~25% |
| C+ | Sabotaj olmadan iç düzenleme + rakibi yavaşlatma | ~25% |
| C | Öncü şirketin kendi inisiyatifiyle yavaşlaması | ~20% |
| D | Tam hızda yarış, güvenliğe minimum kaynak | ~10% |
| S | Süresiz duraklama | Rakip senaryo, farklı denge |
*Bu oranlar yazarlardan Eli Lifland’ın öznel tahminleridir, kesin bilimsel veriler değildir — raporun kendisi de bunu vurguluyor.
Buradaki kritik ayrım şu: Plan A yalnızca “yavaşlamayı” değil, doğrulanabilir ve şeffaf bir yavaşlamayı öngörüyor. Yazarlara göre şeffaflık olmadan yapılan bir yavaşlama anlaşması kırılgan kalıyor; çünkü taraflar birbirinin gizlice ilerlemediğinden emin olamıyor.
Bir Güvenlik Araştırmacısının Gözünden: Plan A’nın Teknik Güvenlik Mimarisi
Raporun “Security in Plan A” ek bölümü, bir SOC/altyapı güvenliği perspektifinden en ilgi çekici kısım. Yazarlar güvenliği üç katmanda ele alıyor:
1. Model ağırlıkları güvenliği (Model Weights Security) Amaç, frontier model ağırlıklarının (ve benzer büyüklükteki veri setlerinin) sızdırılmasını önlemek. Somut hedef: 5 yıl boyunca toplam 100TB’tan fazla sızıntı olmaması (SL5-100TB-5y olarak adlandırılıyor). Önerilen fiziksel önlemler klasik bir “air-gap” mimarisinin ötesine geçiyor:
- Çıkarım (inference) veri merkezlerinin etrafında bir faraday kafesi ile elektromanyetik izolasyon,
- Dışarıya çıkan tek bir kablo üzerinden, sadece doğrulanmış ve onaylı modellerden gelen token’ların akmasına izin verilmesi,
- Ar-Ge veri merkezlerinden çıkan trafiğin saniyede 1 MB ile sınırlandırılması — 5 yılda toplam ~157TB’lık bir “şeffaf çıkış kanalı” öngörülüyor; bunun üzerinden model ağırlıklarını sızdırmak, uzun süre boyunca bant genişliğinin büyük kısmını fark edilmeden kullanmayı gerektireceğinden pratikte çok zor olacak.
2. Doğrulama bütünlüğü (Verification Integrity) ABD ve Çin’in birbirine güvenebilmesi için, hangi işlem gücünün onaylı işler için kullanıldığını doğrulayan mekanizmaların (ağ trafiği dinleme noktaları, güvenilir yeniden hesaplama sunucuları) her iki tarafça da manipüle edilemez olması gerekiyor. Bu, kritik altyapı güvenliğinde bildiğimiz “chain of custody” ve “tamper-evidence” ilkelerinin devlet-devlet ölçeğine taşınmış hali.
3. Algoritmik gizlilik (Algorithmic Confidentiality) “Tam Araştırma Şeffaflığı” senaryosunda algoritmik sırların büyük kısmı zaten ortadan kalkıyor; ancak büyük veri setleri ve hesaplama yoğun şekilde bulunan hiperparametreler için ayrı sızıntı önleme mekanizmaları öneriliyor.
Yazarlar, bu güvenlik seviyesinin (RAND’ın tanımladığı OC5 seviyesinde bir saldırgana karşı SL5) “aşırı çaba ile ulaşılabilir” olduğunu ama bunun düşük güvenle yapılmış bir tahmin olduğunu, teknik olarak imkânsız çıkabileceğini de açıkça belirtiyor.
Kısa Vadede Uygulanabilir Öneriler
Plan A’nın tam olarak hayata geçmesi uzak bir ihtimal olsa da, rapor daha mütevazı ama hemen uygulanabilir politika adımları da öneriyor:
- İç (internal) ve dış (external) model dağıtımı arasındaki şeffaflık farkının azaltılması — asıl risk, dışarıya kapalı, şirket içinde kullanılan modellerden geliyor.
- Mevcut ihracat kontrollerinin (export controls) daha sıkı uygulanması; rapor, Çin’in toplam işlem gücünün yaklaşık üçte birinin kaçak yollarla temin edildiğini aktarıyor.
- Doğrulama teknolojilerine (verification R&D) yatırım.
- Şirketlerin AI Ar-Ge’sine ayırdığı işlem gücü bütçesinin sınırlandırılması.
- Devletlerin kendi bünyesinde nitelikli AI yeteneği geliştirmesi — rapor, ABD hükümetinin bu konuda ciddi bir yetenek açığı olduğunu vurguluyor.
Değerlendirme
Plan A’yı okurken beni en çok etkileyen, senaryonun “iyimser” bir gelecek tahayyül ederken bile ne kadar zorlu bir mühendislik ve diplomasi problemi ortaya koyduğu. Bir sistem yöneticisi ve güvenlik araştırmacısı gözüyle bakıldığında, burada anlatılanlar aslında tanıdık bir problem: güven sıfır (zero-trust) mimarisini devlet ölçeğine taşımak. Faraday kafesleri, bant genişliği sınırlamaları, çok taraflı doğrulama mekanizmaları — bunların hepsi, kurumsal SOC ortamlarında uyguladığımız ilkelerin çok daha yüksek riskli bir versiyonu.
Rapor, herkesin hemfikir olacağı bir plan değil elbette — yazarların kendileri bile Plan A’nın gerçekleşme olasılığını düşük görüyor (%3-15 aralığında). Ama tartışmayı somut bir zemine oturtması, “güvenlik” ve “yönetişim” kelimelerini soyut sloganlar olmaktan çıkarıp mühendislik problemlerine dönüştürmesi açısından okunmaya değer.
Raporun tamamını ve interaktif ek bölümlerini (doğrulama planı, şeffaflık planı, kapasite ölçekleme stratejisi) ai-2040.com adresinden inceleyebilirsiniz.
Bu yazı, AI Futures Project ekibi (Thomas Larsen, Romeo Dean, Brendan Halstead, Eli Lifland, Ryan Greenblatt, Daniel Kokotajlo) tarafından yayınlanan “AI 2040: Plan A” raporunun bir özeti ve değerlendirmesidir. Rapor bir tahmin değil, bir politika önerisi ve senaryo çalışmasıdır.